
ECの在庫連携・基幹連携が突然止まったときの原因の切り分け方|仕様変更・トークン切れ・タイムアウトを見分ける

目次
【AIによる要約】
– 在庫連携・基幹連携が止まったら、まずエラーログのHTTPステータスコードで原因を3類型に切り分けます。
– 認証系(401・403)、タイムアウト系(408・504)、仕様変更系(400・422)の見分け方を押さえると対応が一気に早まります。
– ベンダーへの調査依頼は「いつから・どの範囲で・どんなエラーか」を1枚にまとめるのが最短ルートです。
朝起きたら在庫が更新されていない——EC運営者なら一度はある光景です
ECサイトの在庫が朝になっても更新されていない。受注データが基幹システムに届いていない。
ECと基幹システム(受発注・倉庫・会計など)をAPIでつないで運営されている会社では、このトラブルは珍しくありません。当社も自社でEC事業を運営しており、また300社以上のWeb・ECサイトの支援を通じて、この「連携が突然止まる」案件に何度も立ち会ってきました。
ここで怖いのは、連携が止まってもECサイト自体は普通に表示されることです。フロントが生きているため、気づくのが遅れる。気づいたときには在庫切れの注文を受けていた、二重登録が起きていた、という二次被害につながります。
この記事では、ベンダーに調査を依頼する前に自社でできる切り分けの手順と、依頼時に渡すべき情報のまとめ方を解説します。ポイントは「エラーの3類型」で考えることです。
まず押さえる「エラーの3類型」
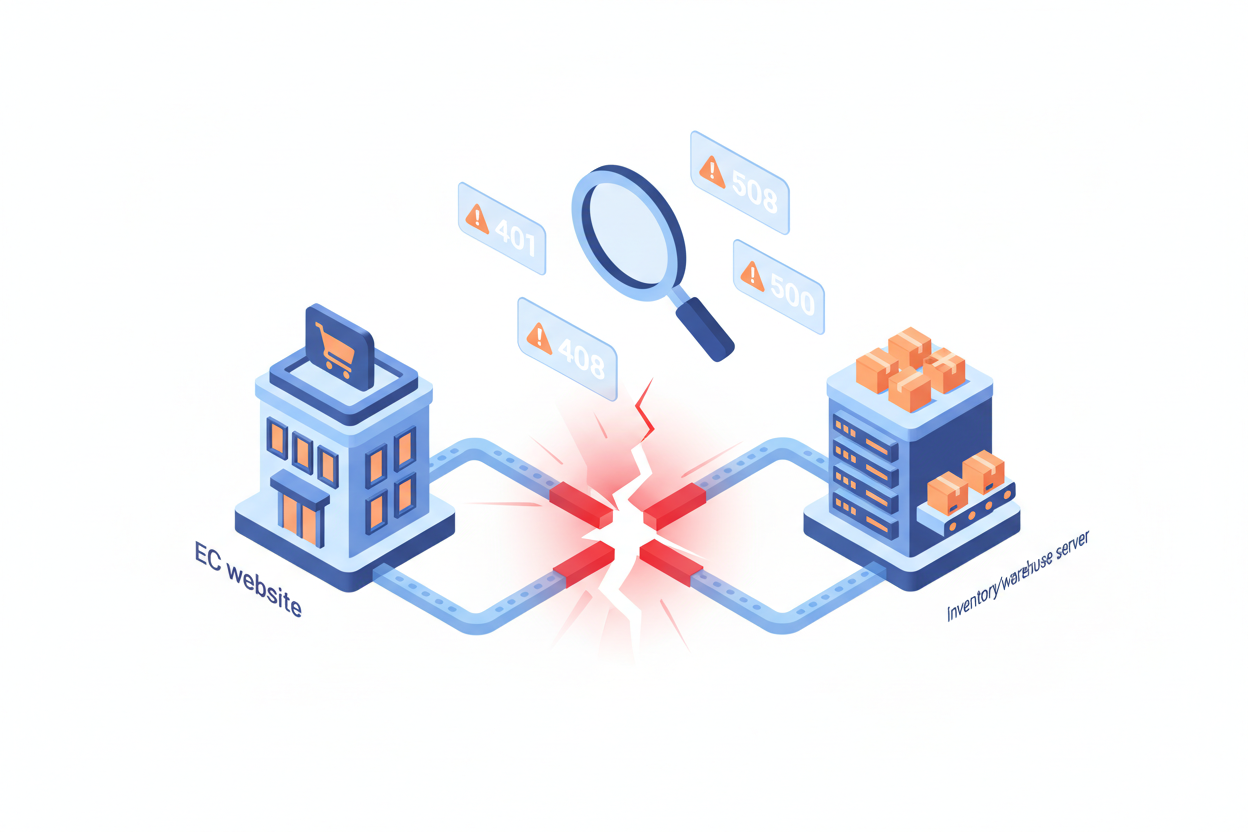
API連携が止まる原因は、大きく次の3つに分類できます。ログに残るHTTPステータスコードを見れば、どの類型かはほぼ判別できます。
| 類型 | 代表的なステータスコード | 起きていること |
|---|---|---|
| 認証エラー | 401 / 403 | APIキーやトークンが無効・期限切れ。相手先の仕様変更も多い |
| タイムアウト・応答異常 | 408 / 504 / 接続エラー | 相手サーバーが重い、応答しない、ネットワーク経路の問題 |
| 仕様変更・パラメータ異常 | 400 / 422 / 415 | 相手側のAPI仕様が変わり、送り方が合わなくなった |
ログが残っていなければ話になりません。まず「連携ジョブのログはどこに残る設計か」を把握しておくことが、切り分けの前提になります。ログすら残っていない案件は、当社の経験上、復旧までの時間が大きく伸びます。
切り分け手順:ログ→期間→範囲→相手側の告知
ステップ1:ログのエラーと「最初の失敗時刻」を確認する
連携ジョブのログを開き、最初に失敗した日時と、そのときのHTTPステータスコードを記録します。以降の判断はすべてここから始まります。
- 401 / 403 → 認証系。ステップ3へ
- 400 / 422 / 415 → 仕様変更系。ステップ4へ
- 408 / 504、または接続自体が失敗 → タイムアウト系。ステップ2へ
ステップ2:タイムアウト系なら「相手側の一時的な重さ」を疑う
タイムアウトは相手サーバーの一時的な高負荷やメンテナンスで起きることが多く、一定時間後に自然復旧するケースもあります。
- 数時間おいて手動で連携を再実行し、復旧するか確認する
- 復旧するなら「間欠的な高負荷」、復旧しないなら経路や設定の問題の可能性
- 同じ時間帯だけ失敗するなら、相手側のバッチ処理と重なっている可能性もあります
この類型は焦って設定をいじると状況が悪化します。まず再実行と経過観察が基本です。
ステップ3:認証系なら「トークン切れ」と「仕様変更」を確認する
401・403で止まっている場合、確認順序は次のとおりです。
- トークン・APIキーの有効期限:多くのAPIはトークンに有効期限があります。期限切れなら再取得手順を踏むだけで復旧します
- IPアドレス制限の変更:自社サーバーのIPが相手側の許可リストから外れていないか。自社側のサーバー移転・IP変更直後に起きる定番の落とし穴です
- 認証方式の変更:Basic認証からOAuthへの移行など、相手側が認証方式を変えているケース。後述の相手側の告知を確認します
ステップ4:仕様変更系なら「相手側の告知」を探す
400・422系のエラーが突然出始めた場合、相手側のAPI仕様が変わった可能性が高いです。
- 相手サービスの公式サイト・開発者向けドキュメント・通知メールを確認する
- 「廃止予定(deprecation)」の告知が出ていたAPIを使い続けていたケースは非常に多いです
- バージョン付きAPI(例:
/api/v1/)を使っているなら、v1の提供終了が近づいていないか確認します
ここまでで類型と当たりがつけば、ベンダーへの依頼は格段に早くなります。
ベンダーに渡すべき情報は「1枚」にまとめる
調査依頼で現場が一番困るのは、情報が断片的に届くことです。次の項目を1枚にまとめて渡してください。当社が調査を引き受ける立場になっても、この1枚があるだけで初動が半日単位で短縮されます。
- 発生日時:最初に失敗した日時と、それ以降の発生頻度
- エラーログ:HTTPステータスコードとエラーメッセージ(全文)
- 影響範囲:在庫・受注・顧客データのどれが止まっているか、手動運用で回避できているか
- 直近の変更:自社側でサーバー移転・SSL更新・コード改修などをしたか(した場合は日時)
- 相手側の告知:仕様変更・メンテナンス告知の有無とURL
「直近の変更」は特に重要です。トラブルの多くは、障害と無関係に見える自社側の変更がきっかけで起きます。連携が止まった2週間前にサーバーを移転していた、というケースを当社は実際に何度も経験しています。
やりがちだが危ないこと
- 手動で在庫を打ち直して済ませてしまう:応急処置としては有効ですが、復旧後の二重反映・在庫ズレの温床になります。手動対応の期間と件数は必ず記録しておいてください
- エラーが出るたびに連携を再起動する:認証系や仕様変更系のエラーでは再起動は無意味です。リトライが攻撃と誤検知され、IP制限をかけられるリスクすらあります
- 連携の失敗通知のない運用を続ける:止まっていても誰も気づけない状態が一番危険です。連携ジョブの死活監視とエラー通知は、最低限の防御線として必ず入れてください。夜間・休日に止まる連携を人間の目視で拾うのは現実的ではないためです(死活監視の重要性についてはサイトの「死活監視」とは?夜間や休日にサーバーが落ちても即座に検知する仕組みの重要性で解説しています)
自社で対応する範囲と、プロに任せるべき境界
ここまで読んでいただければ、境界は明確です。
自社でできること:ログの確認、ステータスコードの記録、トークン再取得、相手側の告知確認、手動連携での応急運用。
プロに任せるべきこと:API仕様変更へのコード改修、認証方式の移行対応、連携ジョブの監視・通知の設計、基幹システム側との仕様調整。
判断基準はこう言い切ってよいと考えています。「ログが読めて原因の当たりがつけられるなら自社で初動、ログの残し方自体に問題がある、またはコード改修が必要なら、その時点で即ベンダーに依頼する」、これが基準です。仕様変更への改修は、相手側の提供終了スケジュールとの勝負になります。ここで数週間悩むのは、在庫ズレのリスクを増やすだけです。
まとめ
- API連携の停止は、エラーの3類型(認証・タイムアウト・仕様変更)で切り分ける
- 最初の失敗時刻とステータスコードが、すべての判断の出発点
- ベンダーへの依頼は「発生日時・ログ・影響範囲・直近の変更・告知」の1枚で
- 止まっていること自体を検知できない運用が最大のリスク
当社は自社でもEC事業を運営しながら、300社以上のWeb・ECサイトの保守・トラブル対応に携わってきました。連携まわりの監視・通知の設計から、仕様変更への改修まで、一貫して対応可能です。「連携が止まっていることに気づけない仕組み」に不安がある方は、Webサイト保守管理サービスからご相談ください。