
「深夜の定期バッチが止まっていた」— cronのエラーは誰にも届かない?定期処理の検知と監視設計

目次
【AIによる要約】
– 定期バッチは止まってもサイトにエラーが出ないため、気づいたときには数日以上が経過しています。
– cronの終了コードとログを見る監視を入れれば、深夜の停止も翌朝には検知できます。
– まずは稼働中の全cronを台帳化し、「止まったら誰に通知するか」を決めるのが最短の初手です。
朝一番の在庫連携が、いつの間にか動いていない——その異変に気づくのは誰か
ECサイトの在庫が朝になっても更新されていない。問い合わせの自動返信メールが届いていない。受注データが基幹システムに上がっていない。
こうした「裏側で動き続けているはずの定期処理」が、ある日を境に静かに止まっていた——このトラブルは、在庫連携やメール配信などでシステムを運営されている会社では珍しくありません。当社も自社でEC事業を運営しており、300社以上のWeb・ECサイトの支援を通じて、この「止まったまま誰も気づかない」案件に何度も立ち会ってきました。
怖いのは、サイトの画面には何も表示されないことです。フロントは普通に商品を表示し、カートも動いています。異常に気づくのは「在庫切れの注文が増えた」と顧客から連絡が来たとき。そこから何日も前から止まっていたと分かり、ダメージの範囲すら特定できない状態で対応が始まります。
この記事では、なぜ定期バッチは黙って止まるのか、放置すると何が起きるのか、そして明日から使える検知・監視の設計を解説します。
なぜcronは「黙って」止まるのか
cron(クーロン)は、Linuxサーバー上で決まった時刻にプログラムを自動実行する仕組みです。深夜2時に在庫連携、3時にバックアップ、という具合に、人が見ていない時間帯の処理を任せています。
この仕組みには、運用上の落とし穴がいくつかあります。
| 落とし穴 | 起きること |
|---|---|
| エラーがどこにも届かない | 失敗しても通知先が設定されておらず、エラーが握りつぶされる |
| ログが上書きされる | 毎回同じファイルに書き出す設計だと、前回失敗の証拠が消える |
| crontabの消失 | サーバー移転やOS更新時にcron設定が移行されず、ジョブごと消える |
| パス・環境の違い | 手動では動くのにcronでは動かない(実行ユーザーやPATHが異なる定番問題) |
特に厄介なのが1つ目です。cronの仕事は「決まった時刻に実行する」ことだけで、処理が成功したか失敗したかを誰かに伝える仕組みは持っていません。失敗を検知する仕組みは、運用側が別途組み込む必要があります。
放置すると何が起きるのか:当事者としての損失感覚
当社は自社でも複数のEC・Webサービスを運営しているため、「連携が止まったまま数日経過」がどれほど痛いかを当事者として知っています。主な被害は次のとおりです。
- 在庫連携の停止:売り切れ商品が「在庫あり」のまま注文を受け、欠品お詫びとキャンセル対応が発生する。繁忙期ほど注文量が多く、ダメージが増幅します
- 受注連携の停止:注文データが基幹システム・倉庫に届かず、出荷遅延と問い合わせ殺到につながります
- バックアップの停止:いざ復旧しようとしたときに「バックアップが止まっていた」ことに気づく。最悪のタイミングで効く地雷です
- 復旧後の二重処理:止まっていた期間のデータを後から一括投入する際、重複登録や抽出漏れが起きやすく、訂正対応に時間を取られます
さらに、深夜バッチは深夜に止まるため、気づきが翌営業日にずれ、回復までの損失期間が伸びます。サイトの死活監視(サイトの「死活監視」とは?夜間や休日にサーバーが落ちても即座に検知する仕組みの重要性)を入れていても、サイト自体が生きていれば検知できません。バッチ専用の監視が別途必要というのが、本質的なポイントです。
検知の3原則:終了コード・ログ・完了通知
監視設計は難しくありません。次の3つを押さえるのが基本形です。
原則1:終了コードとエラー出力を握りつぶさない
スクリプトは失敗したら「異常終了」の合図(終了コード1など)を返す設計にし、失敗時に通知を飛ばします。この構造ができれば監視の土台は完成です。cronの標準出力・標準エラー出力を /dev/null に捨てる設定は運用上の事故です。まず全ジョブのcrontabを確認し、出力がどこへ飛んでいるかを把握してください。
原則2:日付付きログで「いつから止まっているか」を残す
ログは日付ごとに別ファイルにします(例:batch_20260919.log)。上書き型のログでは失敗の起点が分からず、影響範囲の特定に余計な時間を溶かします。「いつから」が分かることは、復旧後のデータ訂正にも直結します。
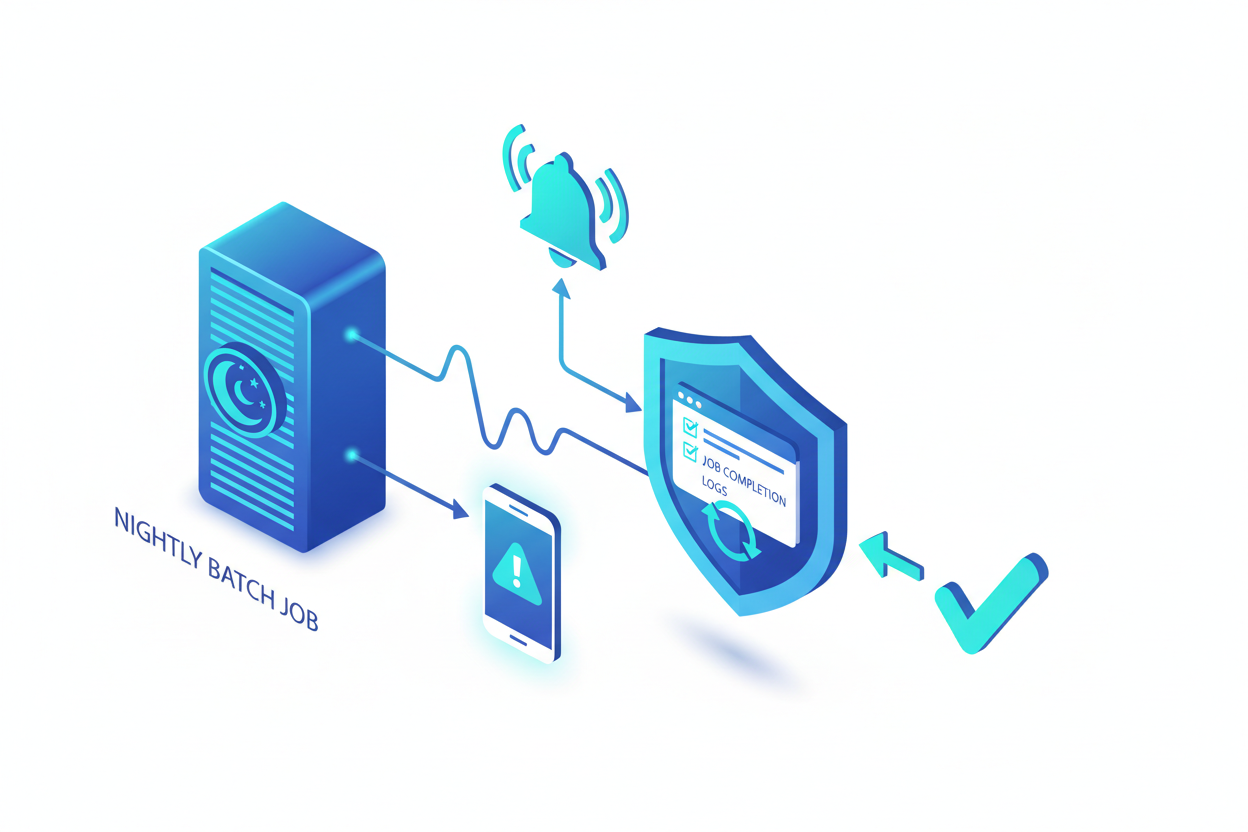
原則3:成功・失敗の両方を通知する「完了報告」型にする
失敗だけを通知する設計には弱点があります。ジョブ自体が走らなかった場合、失敗の通知すら届かないのです。サーバー停止、cron設定の消失、スクリプトのリネーム——こうした「静かな消滅」を拾うには、成功時にも通知(ハートビート)を送り、通知が来ないこと自体を異常として扱う設計が有効です。ジョブ実行を監視する外部サービスもこの仕組みを提供しており、低コストで導入できます。
通知先まで含めて設計する:「誰に・いつ・どう動くか」
検知はゴールではなく、通知が実際に人に届き、対応が動くことまでが設計です。
| 設計項目 | 決めること |
|---|---|
| 通知先 | 担当者1名だけにしない。代理の宛先を含め、グループ宛(メール・チャット)にする |
| 対応の分類 | 自動再実行で直るもの / 手動確認が要るもの / ベンダー依頼のものを分ける |
| 依頼フロー | 業者保守に入っているなら、深夜バッチ障害の連絡先と受付可否を事前確認 |
| テスト | 四半期に1回、実際に通知が飛ぶか確認する。「設定したつもり」は裏切られる |
ここで押さえたいのは、監視ツールの役割は検知までだということです。落ちたジョブを直すのは人の判断と作業です。通知が届いた後に誰が何をするかまで決まって初めて、監視体制として機能します。
自社でできる範囲と、プロに任せる範囲の境界線
私たちの見解としては、境界はこうです。
- 自社でできる:稼働中cronの一覧化、ログ出力先の確認、通知先の決定、外部監視サービスの導入
- プロに任せるべき:スクリプト自体への失敗検知の組み込み、cron不発・多発の原因調査、連携停止時のデータ訂正
特に後段の「データ訂正」は、止まっていた期間の注文・在庫をどう整合させるかの判断が伴い、誤ると二重登録や欠番などの二次障害を起こします。当社ではこうした連携障害の原因切り分け(ECの在庫連携・基幹連携が突然止まったときの原因の切り分け方|仕様変更・トークン切れ・タイムアウトを見分ける)から復旧後のデータ整理まで、専任エンジニアが一貫して対応しています。代理店を挟まない直接取引で、障害の初動から運用改善まで同じ担当が見る体制は、深夜バッチのような「目に見えにくい領域」で特に効いてきます。
明日から使えるチェックリスト
- 稼働中の全cronジョブの一覧を確認できるか
- 各ジョブのエラー出力が廃棄されていないか(
/dev/null捨てが無いか) - ログが残る設計になっているか
- ジョブ自体が不発になった場合も検知できる仕組み(完了報告・ハートビート)があるか
- 問題に気づいた時に相談できる先があるか
6項目中3つ以上が「いいえ」なら、バッチは止まっても気づけない、または対処できない状態です。
まとめ:止まっても動き続けるサイトに、監視で「異常」を見える化する
定期バッチは、止まってもサイトに何も表示されないがゆえに、最も放置されやすい領域です。cronは通知の仕組みを持たず、監視は運用側の設計次第。終了コード・日付付きログ・完了報告型の通知という基本形を押さえれば、深夜の停止も翌朝には検知できます。
当社カジヤは業界歴10年以上、300社以上のWeb・ECサイトの支援実績があり、自社でもEC事業を運営する当事者として、監視設計から障害対応・データ訂正までを一貫して支援しています。「うちの定期処理、大丈夫か不安」という段階のご相談も歓迎です。まずはお問い合わせフォームから、現状をざっくりお聞かせください。